
Innhold
Guide til datakontrakter

Kategori: Data Governance | Emneknagger: #podcast, #datakontrakter, #dataprodukter, #dbt
En datakontrakt er en avtale mellom de som lager data og de som bruker dem, skrevet slik at en maskin kan teste den. Guiden viser hva kontrakten inneholder, hvordan den håndheves med ODCS og dbt, og hvordan dere kommer i gang med ett team og ett dataprodukt.
Kort fortalt: En datakontrakt er en avtale mellom de som lager data og de som bruker dem, skrevet som kode slik at en maskin kan teste den hver gang dataene endres. Kontrakten gir produsenten en liten og kjent kostnad, og sparer konsumentene for feilene som kommer når dataene endres uten at noen sier fra. Verktøyene for å teste kontrakten finnes, og i prosjektene våre er det eierskapet og oppfølgingen som avgjør om den virker.
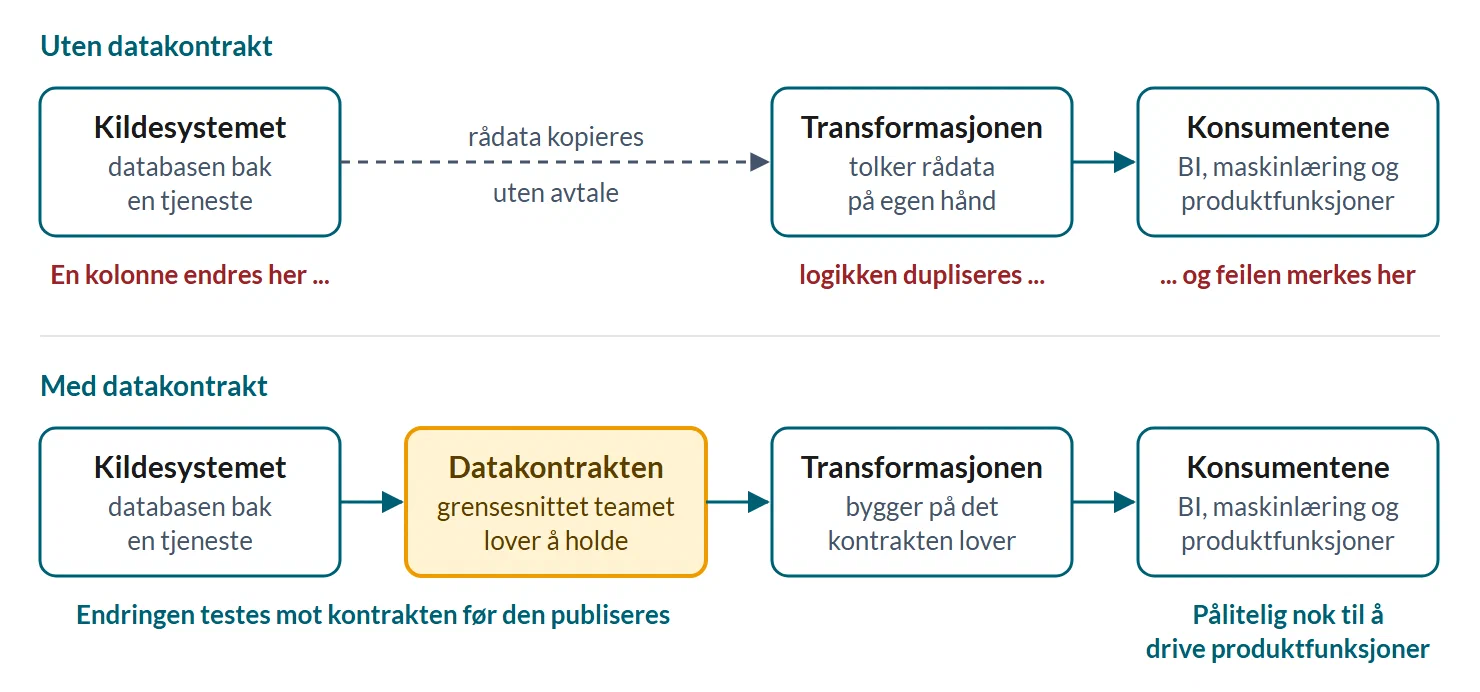
Når en utvikler endrer en kolonne i en database, kan det føre til at en rapport feiler, en maskinlæringsmodell gir feil, eller et dashboard slutter å virke. Data flyter mellom systemer og mennesker, og ofte skjer det uten tydelige avtaler.
Slike feil oppstår ikke fordi folk gjør feil med vilje, men fordi avhengighetene er skjulte. Ingen har sagt ifra hva som er lov og ikke. Og ingen fanger opp at noe har gått galt, før det går galt.
Kostnaden er vanskelig å se, fordi den havner et annet sted enn der endringen ble gjort. Andrew Jones, som skrev en av de første bøkene om datakontrakter, peker på at det nesten ikke koster produsenten noe å la være å love noe om dataene. Konsumentene må gjette strukturen, rykke ut når noe endres og fylle pipelinene sine med IFNULL og COALESCE for hver variant dataene har hatt. Den kostnaden ganges med antall konsumenter.
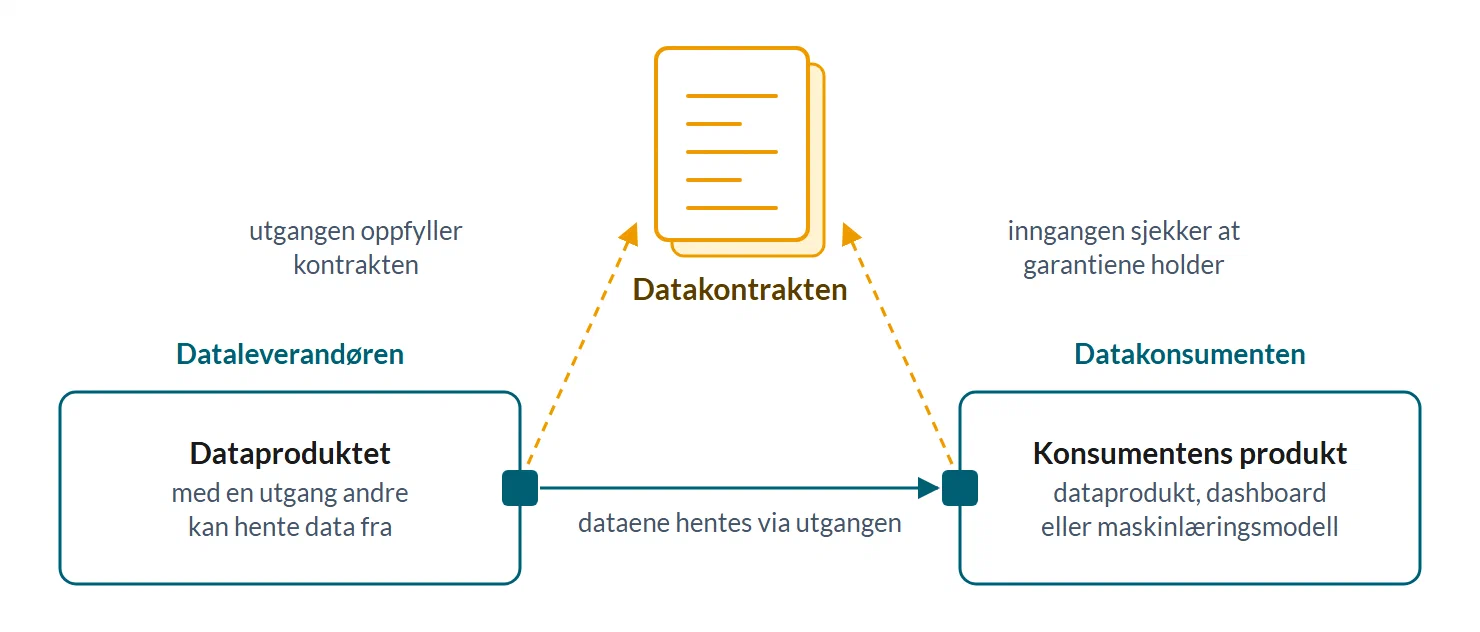
En datakontrakt fungerer som et API for data, en spesifikasjon av struktur, kvalitet og forventninger som både produsenter og konsumenter forholder seg til. Den flytter en liten del av kostnaden over til produsenten, som må beskrive dataene og holde beskrivelsen ved like. Til gjengjeld er kostnaden kjent, den samme som for å vedlikeholde et API, og konsumentene slipper nesten alle feilene som kommer av endringer de ikke visste om.
I takt med at plattformer blir mer desentraliserte, og flere team produserer egne dataprodukter, vokser behovet for tydelige og teknisk validerbare avtaler mellom de som eier data og de som bruker dem. I kapittelet om grensesnitt og datakontrakter i guiden om dataprodukter skriver vi om når en kontrakt lønner seg, og når det holder med mindre.
Hvilke problemer løser datakontrakter?
Datakontrakter løser tre problemer. De gjør avhengighetene mellom team synlige, slik at en endring som ødelegger for andre, stoppes før den når produksjon. De gir et felles grunnlag når data deles på tvers av virksomheter og sektorer. Og de gjør det mulig å bygge større økosystemer der flere aktører bruker de samme definisjonene.
Færre feil i dataflyten
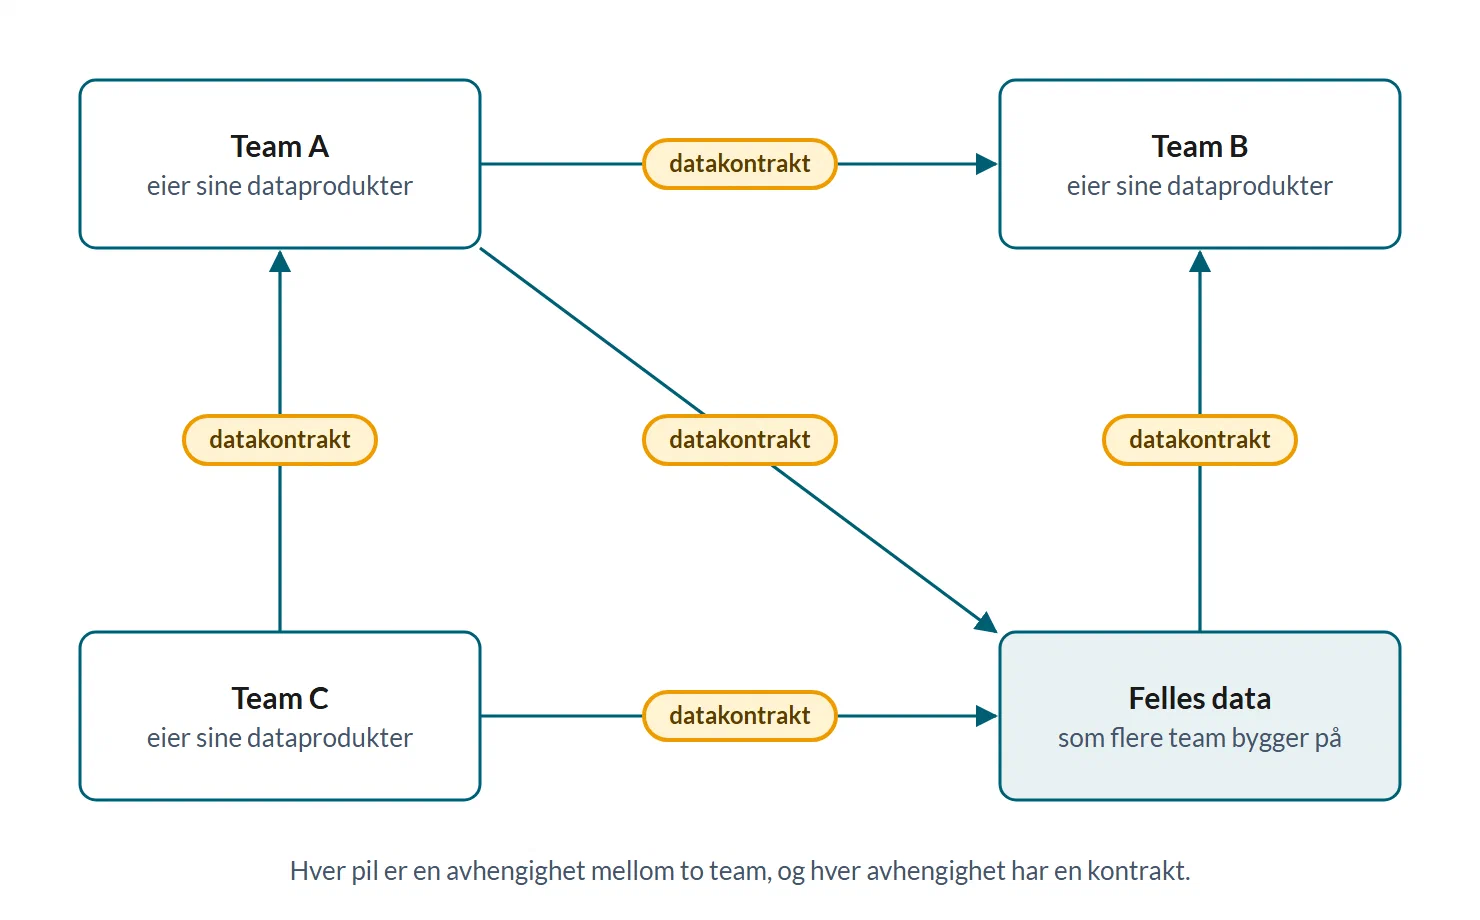
Når avhengighetene er synlige og kan testes, kan teamene bygge løsninger som både er selvbetjente og pålitelige.
Monzo, den britiske digitalbanken, har publisert tall fra arbeidet med slike avtaler. Over 100 team bidrar til et datavarehus med mer enn 12 000 dbt-modeller, og banken innførte det den kaller grensesnitt: en dbt-modell som et team har erklært som en kontrakt andre team kan bygge på. Da rundt 30 prosent av migreringen var gjort, meldte Monzo om rundt 40 prosent lavere kostnader og rundt 25 prosent raskere levering av data i noen av domenene. Gevinsten kommer av hele ombyggingen, med faste modellag og automatiske standarder i CI i tillegg til grensesnittene, og banken skriver selv at det er tidlig. Grensesnittene har også en pris. Teamet som eier et grensesnitt, må dokumentere det, teste det og holde det stabilt, og det er den kjente kostnaden produsenten tar for at de andre teamene skal slippe.
Bedre støtte til datadeling
Offentlige og sektorovergripende krav stiller også høyere forventninger til strukturert datadeling:
- Dataforvaltningsloven fra juni 2026 følger opp NOU 2024: 14 Med lov skal data deles. Loven gjennomfører åpne data-direktivet og dataforvaltningsforordningen (Data Governance Act) i norsk rett. Den gir rett til å kreve at data gjøres tilgjengelig for viderebruk, og stiller krav til hvordan metadata publiseres. Kongen bestemmer når loven trer i kraft.
- PSD2 krever at banker gir tredjeparter sikker tilgang til kontodata, i praksis via API-er, og det har åpnet nye markeder og gjort delingen tryggere.
Datakontrakter er et praktisk svar på slike krav, og kan sees på som en teknisk implementasjon av prinsippene bak reguleringen.
Økt verdi i større økosystemer
Datakontrakter må være forståelige og implementerbare. Her er det mye å lære av andre standardiseringsforsøk, som har bevist sin verdi over tid:
- HL7 (helse): svært detaljert, men for komplisert i praksis
- EHF (handel og økonomi): enkel nok til å fungere, bredt tatt i bruk
Dette er eksempler der datakontrakter gir verdi på tvers av et helt økosystem. Men vi ønsker oss en implementering av datakontrakter som ligner mer på EHF enn HL7, der minimumskravene på sikt blir standardisert for et bruksområde, en type data eller en bransje.
Hvordan henger datakontrakter sammen med distribuerte datateam og dataprodukter?
Når ansvaret for data er fordelt på flere team, eier hvert team sine egne dataprodukter, og andre team bygger videre på dem. Datakontrakten gjør dataproduktet til noe andre kan stole på. Den sier hva som leveres, med hvilken kvalitet og hvor ofte, og den testes hver gang produktet endres. Data mesh er den mest kjente modellen for å organisere data slik, og prinsippene har vi beskrevet i guiden til data mesh.
Data som et produkt
I en distribuert organisering, som i data mesh, fordeler man ansvaret for data på domene- eller produktteam. Disse teamene utvikler egne dataprodukter, ofte i form av tabeller, API-er eller datasett, som andre skal kunne bruke. Dataprodukter må derfor ha tydelige egenskaper: standardiserte, delbare, eid av et team, og forvaltet i hele sitt livsløp. Og husk: ikke alle data kvalifiserer som dataprodukter.
Dataprodukter trenger spesifikasjoner av egenskaper som kvalitet, garanti og service, på samme måte som fysiske produkter:
Når du kjøper en elsparkesykkel, forventer du spesifikasjoner på rekkevidde, garanti og hastighet. Uten disse ville produktet vært vanskelig å selge og umulig å stole på. Det samme gjelder dataprodukter. Uten tydelige spesifikasjoner mister datakonsumentene raskt tilliten, og verdien avtar.
Kontrakten gjør produkttanken til praksis
Datakontrakten blir bindeleddet som gjør «data as a product» til praksis. Den spesifiserer nøyaktig hva som leveres, kvalitet og frekvens (SLA), og brukes aktivt i CI/CD-pipelinen og kommunikasjonen mellom team. Kontrakten gjør at produsentteamet kan spesifisere hva de lover å levere, og konsumentteamene kan stole på at det de bygger videre på, ikke plutselig endrer seg.
Hvordan ser en datakontrakt ut i praksis?
En datakontrakt sier hvem som leverer hvilke data til hvem, hvor ofte, med hvilke felter og kvalitetskrav, og hva som skjer når kravene brytes. De tre eksemplene under er tenkte, fra bank, energi og industri, og alle tre beskriver oppdatering, felter, kvalitetskrav, varsling og hva dataene betyr.
Eksempel 1: Kundedata i bank- og finanssektoren
Et team i en bank leverer kundedata som dataprodukt til risikostyringsavdelingen. Datakontrakten spesifiserer:
- Oppdatering: hver time, fra kl. 08 til 18.
- Felter: kunde_id, kredittrisiko, lånebeløp, status.
- Kvalitetskrav: ingen duplikater, maks 0,5 % nullverdier.
- Varsling: automatiske varsler ved brudd, integrert med bankens risikostyringssystemer.
- Semantisk definisjon: kredittrisiko beregnes basert på kundens kredittscore, betalingshistorikk og eksterne data.
Risikoteamet kan dermed stole på dataene, og avdekke og håndtere risikosituasjoner raskere.
Eksempel 2: Strømforbruk og nettbalansering i energibransjen
En energileverandør leverer strømforbruksdata fra smarte målere som dataprodukt til nettoperatøren for balansering av strømnettet. Kontrakten spesifiserer:
- Oppdatering: hvert 5. minutt.
- Felter: måler_id, strømforbruk_kWh, tidspunkt, kunde_type.
- Valideringsregler: kun positive verdier, og måler_id må finnes i masterdata.
- Semantikk: strømforbruk_kWh gjelder faktisk forbruk, ikke estimater.
- Prissetting: internfakturering basert på datavolum og oppdateringsfrekvens.
- Varsling: automatisk melding til driftskontrollsystemer dersom verdier uteblir eller er utenfor forventede intervaller.
Dermed kan nettoperatøren balansere strømnettet presist og pålitelig i sanntid, og kostnadene deles åpent.
Eksempel 3: Vedlikehold av maskiner i industriproduksjon
Et produksjonsteam leverer sensordata for tilstandsbasert vedlikehold av maskiner til et vedlikeholdsteam. Kontrakten spesifiserer:
- Oppdatering: hvert 15. minutt.
- Felter: maskin_id, temperatur, vibrasjon, driftstid.
- Datakvalitet: maks 1 % unormale verdier, 100 % dekning av kritiske maskiner.
- Varsling: automatisk varsling direkte inn i vedlikeholdssystemer dersom kritiske verdier overstiger terskler.
- Semantisk definisjon: vibrasjon og temperatur brukes til å forutsi maskinslitasje basert på definerte grenseverdier.
Vedlikeholdsteamet kan dermed planlegge vedlikehold før feil oppstår, redusere driftsstans og bruke ressursene bedre.
Hva inneholder en datakontrakt?
En god datakontrakt beskriver tre ting: skjemaet, forretningsreglene og tjenestenivået. I tillegg trenger den en unik ID og en versjon, navnet på datasettet den gjelder, dokumentasjon og en eier. Når grunnmuren står, kan den utvides med personvern, regler for etterlevelse, kobling til begreper og kvalitetsmål.
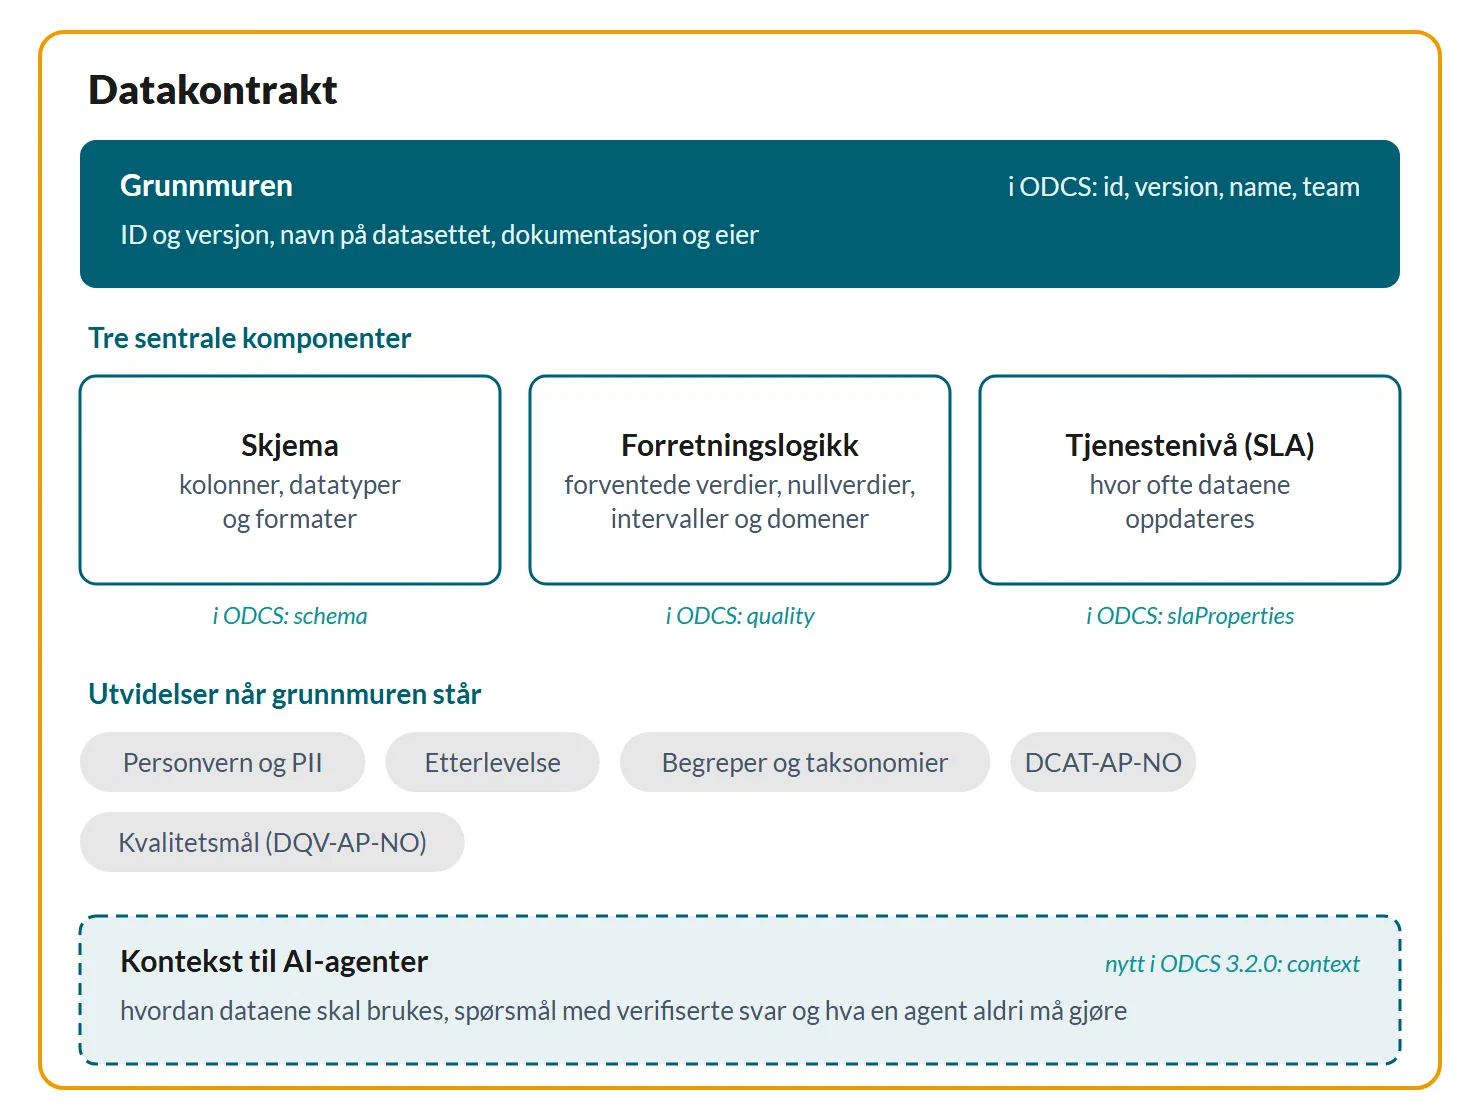
Datakontrakter er en praktisk anvendelse av prinsippet «governance as code». De fungerer som kontraktsfestede grensesnitt for data, og gjør det mulig å spesifisere og validere forventninger til data, helst så tidlig som mulig i utviklingsløpet. I beste fall inngår kontrakten som en integrasjonstest i CI/CD-pipelinen, slik at feil oppdages før kode og data flyttes til produksjon.
Tre sentrale komponenter
En god kontrakt beskriver alltid:
- Skjema: struktur, kolonner, datatyper og formater.
- Forretningslogikk: forventede verdier, toleranse for nullverdier, intervaller og domener.
- SLA-er: hvor ofte dataene oppdateres, for eksempel SLA1 for kritiske data hvert 5. minutt og SLA2 for mindre kritiske data daglig.
Kontrakten bør alltid valideres programmatisk i en CI/CD-pipeline. Hvor den håndheves avhenger av organisasjonens arkitektur og teknologistack, men som et minimum bør den overvåkes, og det bør finnes en prosess for hva som skjer når kontrakten brytes.
Kontrakten som metadataobjekt
I tillegg bør kontrakten ha tydelig:
- ID og versjonskontroll: en unik identifikator for gjenfinning og referanse i pipeline og dokumentasjon, og grunnlaget for å håndtere endringer.
- Ressursnavn og navnerom: hvilket datasett eller hvilken dataressurs kontrakten gjelder for. Bør være 1:1 (for eksempel
vehicle_statusi domenettransport). - Dokumentasjon: hva betyr dataene, og hvordan brukes de? Dokumentasjon bør være påkrevd.
- Eier: produsenten har eieransvaret, og kontrakten utvikles sammen med de viktigste konsumentene.
Når grunnmuren er på plass, kan dere utvide med:
- PII-klassifisering og personvernkrav
- regler for etterlevelse (compliance)
- kobling til taksonomier og ontologier
- beskrivelse etter DCAT-AP-NO, den norske standarden for å beskrive datasett i datakataloger
- kvalitetsmål, for eksempel etter DQV-AP-NO, som bruker dimensjoner som fullstendighet, nøyaktighet, konsistens og aktualitet
Hvor gode dataene må være, avgjøres av hva de skal brukes til. Det skriver vi mer om i Datakvalitet: hvor gode må dataene være, og hvem bestemmer det?
En datakontrakt er ikke bare en spesifikasjon. Den er et testgrunnlag, et styringsverktøy og et viktig bindeledd mellom mennesker og systemer i moderne dataorganisering. Man kan se kontrakten som en forsterket variant av et skjema, men med semantikk, validering, kontekst for bruk og styring bygget inn.
Mer om semantikk og taksonomi
Datakontrakter beskriver ofte én entitet, for eksempel «kunde». Men for at dette skal gi mening, bør det kobles til en semantisk struktur, en taksonomi eller en begrepsmodell. I ODCS kan kontrakten, tabellene og feltene peke til en definisjon utenfor kontrakten, for eksempel i en forretningsordliste eller en datakatalog.
Ved å koble kontrakter til begreper og taksonomier får teamene gjenbruk og forståelse på tvers. «Kunde» kan da være en type «personlig aktør», og kontrakten kan arve regler eller definisjoner derfra.
Hvilke standarder og verktøy finnes?
Den åpne standarden for datakontrakter er Open Data Contract Standard (ODCS), der kontrakten skrives i YAML. Data Contract CLI tester kontrakten mot dataene, og dbt kan håndheve skjemaet hver gang en modell bygges. For hendelser og API-er brukes formater som Avro, JSON Schema og Protobuf. Kontrakten bør leve som kode, sammen med koden som lager dataene.
Open Data Contract Standard
ODCS forvaltes av Bitol, et prosjekt i Linux Foundation AI & Data som i juli 2026 nådde stiftelsens høyeste modenhetsnivå (graduated), og er åpen kildekode under Apache 2.0. Da versjon 3.1.0 kom i desember 2025, faset forvalterne av Data Contract Specification ut sitt eldre format til fordel for ODCS. Versjon 3.2.0 kom i september 2026.
Slik kan bankeksemplet over se ut i ODCS, forkortet:
apiVersion: v3.2.0
kind: DataContract
id: kundedata-risiko
name: kundedata_risiko
version: 1.0.0
status: active
domain: kunde
team:
  name: kundedata
servers:
  - server: produksjon
    type: snowflake
    account: banken-prod
    database: KUNDEDATA
    schema: RISIKO
schema:
  - name: kunde_risiko
    physicalType: table
    properties:
      - name: kunde_id
        logicalType: string
        required: true
        unique: true
      - name: kredittrisiko
        logicalType: number
        description: Beregnes fra kredittscore, betalingshistorikk og eksterne data
        quality:
          - metric: nullValues
            mustBeLessOrEqualTo: 0.5
            unit: percent
slaProperties:
  - property: frequency
    value: 1
    unit: h
Data Contract CLI
Data Contract CLI er et kommandolinjeverktøy med åpen kildekode, bygd på ODCS. Det sjekker at kontrakten er gyldig, kobler seg til datakilden som står under servers i kontrakten, og kjører skjema- og kvalitetstestene mot dataene, blant annet i Snowflake, Databricks, BigQuery, Kafka og Postgres. Versjon 1.0 kom i juni 2026. Kjører dere verktøyet i CI/CD-pipelinen, blir kontrakten en test og ikke bare dokumentasjon:
datacontract test kundedata-risiko.odcs.yaml
dbt-kontrakter
dbt kan håndheve skjemaet når en modell bygges. Med contract: enforced: true må hver kolonne ha navn og datatype, og bygget stopper hvis spørringen gir andre kolonner eller typer enn kontrakten sier. Testene for innholdet ligger ved siden av, under data_tests. Skrivemåten med arguments krever dbt 1.10.5 eller nyere, og i eldre versjoner står values rett under testen:
models:
  - name: transaksjon
    config:
      contract:
        enforced: true
    columns:
      - name: transaksjon_id
        data_type: string
        constraints:
          - type: not_null
        data_tests:
          - unique
      - name: status
        data_type: string
        data_tests:
          - accepted_values:
              arguments:
                values: ["NY", "FERDIG", "ANNULLERT"]
En dbt-kontrakt dekker strukturen. Den sier ingenting om hvor ofte dataene skal oppdateres, hvilke kvalitetskrav som gjelder over tid, eller hvem som eier dem. Den er derfor en del av datakontrakten, ikke hele.
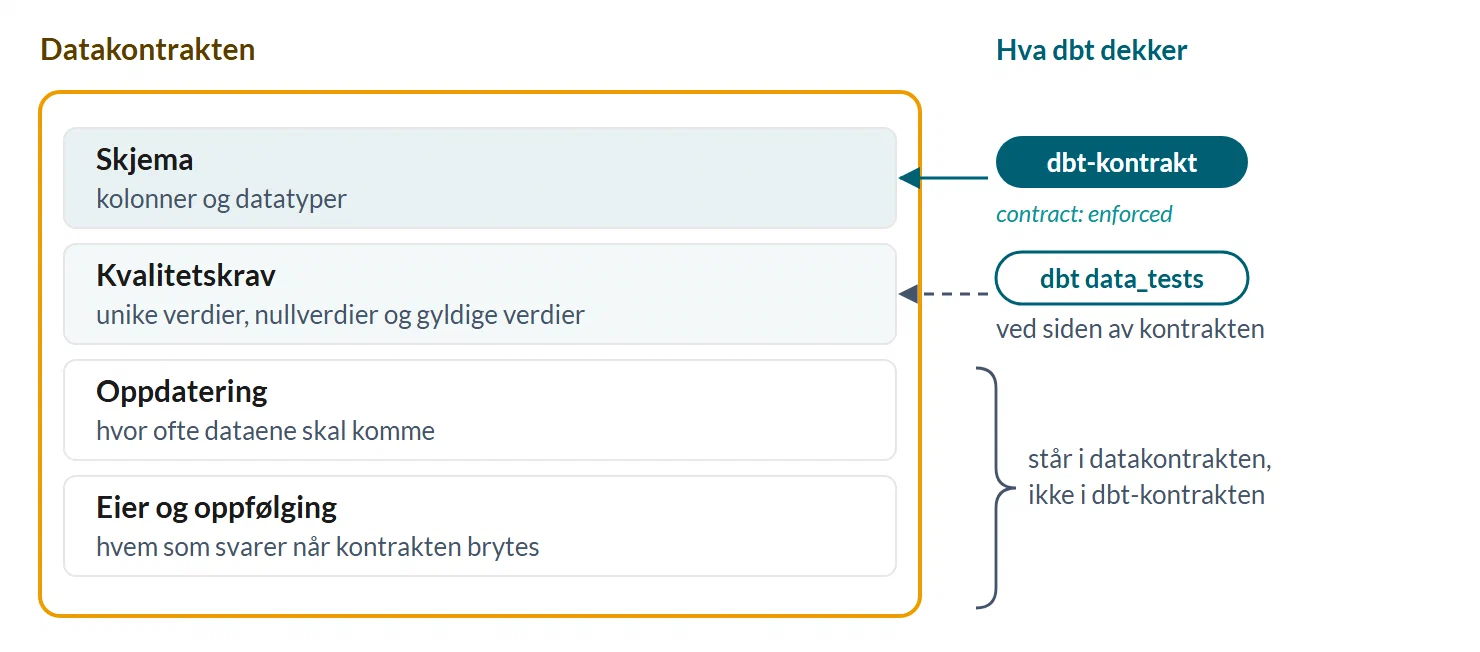
Testverktøy og formater
- Great Expectations (GX Core) brukes til deklarative datatester. Kildekoden ligger nå i Fivetrans GitHub-organisasjon, og prosjektet er fortsatt åpen kildekode under Apache 2.0.
- Soda Core brukes til datasjekker, men har lisensen Elastic License 2.0 og er dermed ikke åpen kildekode i vanlig forstand.
- Avro, JSON Schema og Protobuf brukes for kontrakter i API-er og meldingssystemer.
Hvordan ser arbeidsflyten for en datakontrakt ut?
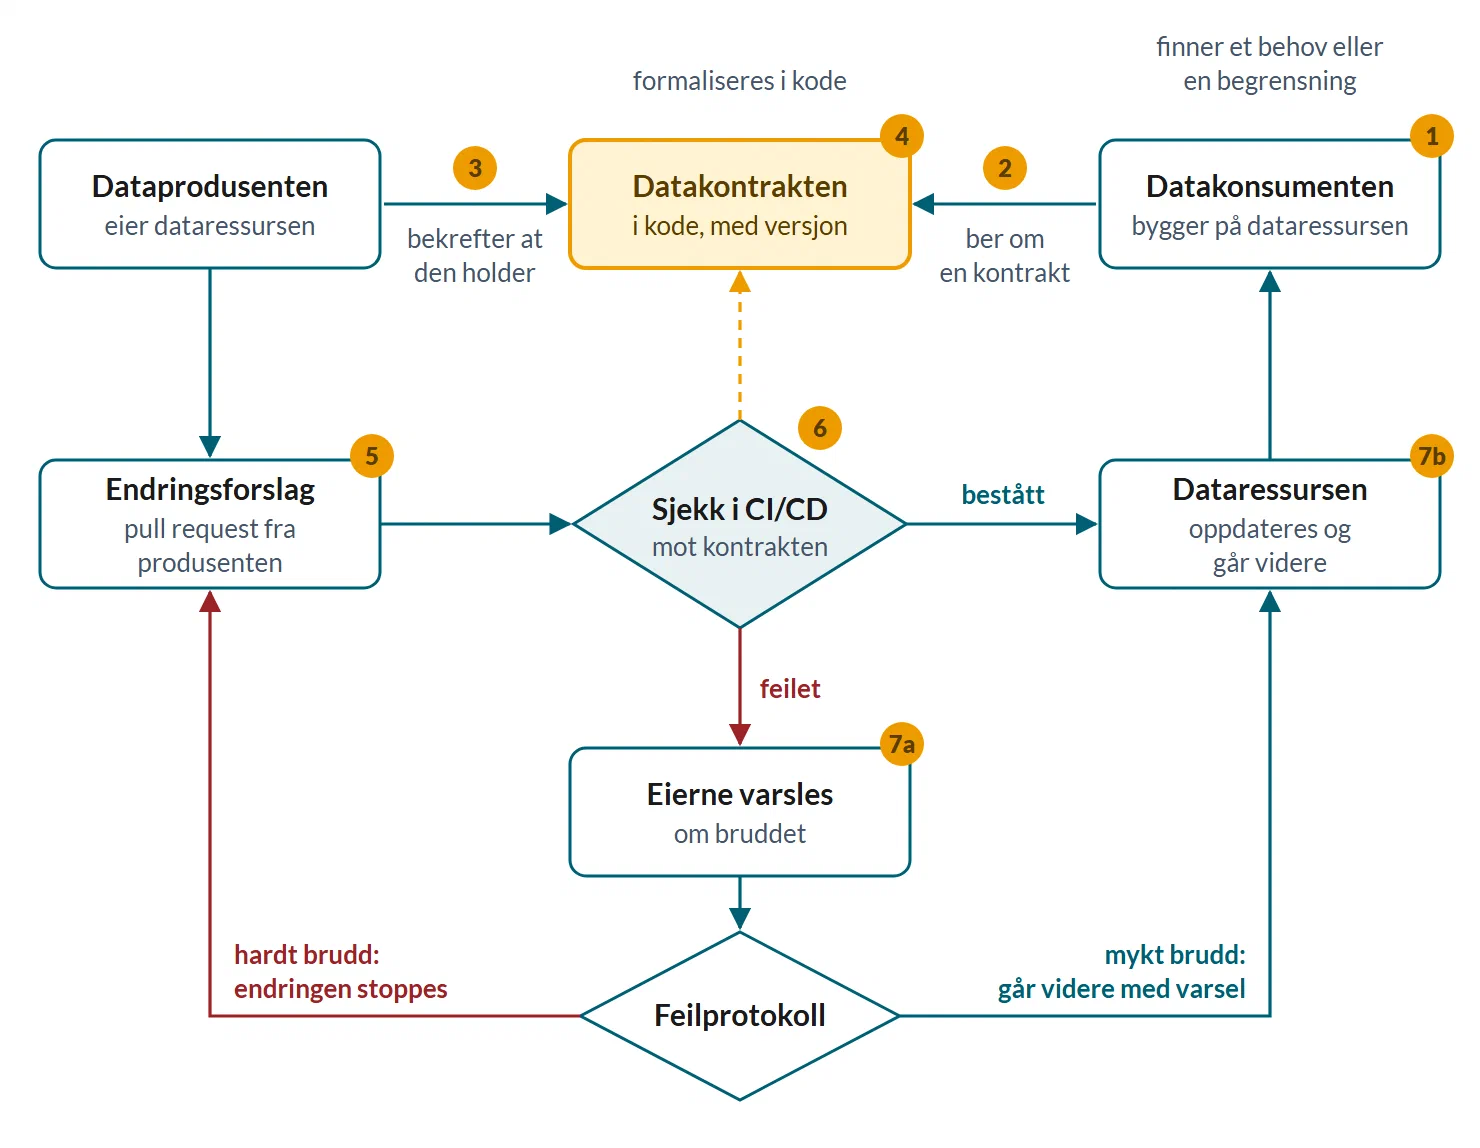
Arbeidsflyten starter hos konsumenten som trenger noe, går via produsenten som bekrefter at det lar seg gjøre, og ender med en kontrakt i kode. Etter det sjekkes hver endring automatisk mot kontrakten. Bryter endringen kontrakten, varsles eieren, og endringen følger en fast feilprotokoll.
Som illustrert i figuren kan arbeidsflyten for datakontrakter bestå av følgende steg:
- Datakonsumenten identifiserer et behov eller en begrensning i dataene.
- Datakonsumenten ber om en datakontrakt for en gitt dataressurs.
- Dataprodusenten bekrefter at datakontrakten er gjennomførbar.
- Datakontrakten bekreftes og formaliseres i kode.
- Dataprodusenten oppretter en pull request for å endre dataressursen.
- Endringen sjekkes automatisk for å se om den bryter med eksisterende datakontrakter.
- Endringen medfører brudd eller ikke brudd: a. Dersom datakontrakten brytes, varsles eieren av dataressursen, og endringen håndteres etter en feilprotokoll. b. Dersom endringen ikke bryter kontrakten, oppdateres dataressursen for videre prosessering.
Hva er de vanligste fallgruvene?
Den vanligste fallgruven er en kontrakt som bare er dokumentasjon. Den testes ikke, endres uten versjonering og har ingen tydelig eier, så den slutter å stemme med dataene uten at noen merker det. Da er kostnaden tilbake hos konsumentene. En god kontrakt er maskinlesbar, testbar, versjonert og eid av produsentteamet.
En annen fallgruve er å legge kontrakten der problemene blir synlige, mellom datavarehuset og rapportene. Der må den jage etter data som alt har endret seg. Mark Freeman II, en av forfatterne bak boka Data Contracts, forteller om et prosjekt med selvbetjent analyse som han måtte stanse etter seks måneder, fordi analysedatabasen lå en dag bak produksjonen av data i kildesystemet, og dermed ikke fulgte endringene. Kontrakten bør stå så nær kilden som mulig, i koden som endrer databasen. Data fra leverandører og andre utenfor virksomheten kan dere ikke stoppe ved kilden, og der bør et brudd settes i karantene før dataene går videre.
Typiske fallgruver:
- Kontrakten er bare dokumentasjon, og den testes ikke
- Endringer skjer uten versjonering, og det konsumentene har bygd, brekker
- Ingen tydelig eier
- Ingen følger opp når kontrakten brytes, så varslene blir liggende
- Kontrakten står der feilene blir synlige, langt fra der de oppstår
- dbt-kontrakten blir tatt for hele datakontrakten, selv om den bare sjekker kolonner og typer
En god kontrakt:
- er maskinlesbar
- er testbar
- er versjonert
- har forankret eierskap i produsentteamet
- er forankret hos de viktigste konsumentene
- har en klar prosess for endringshåndtering
Eier produsenten eller konsumenten kontrakten?
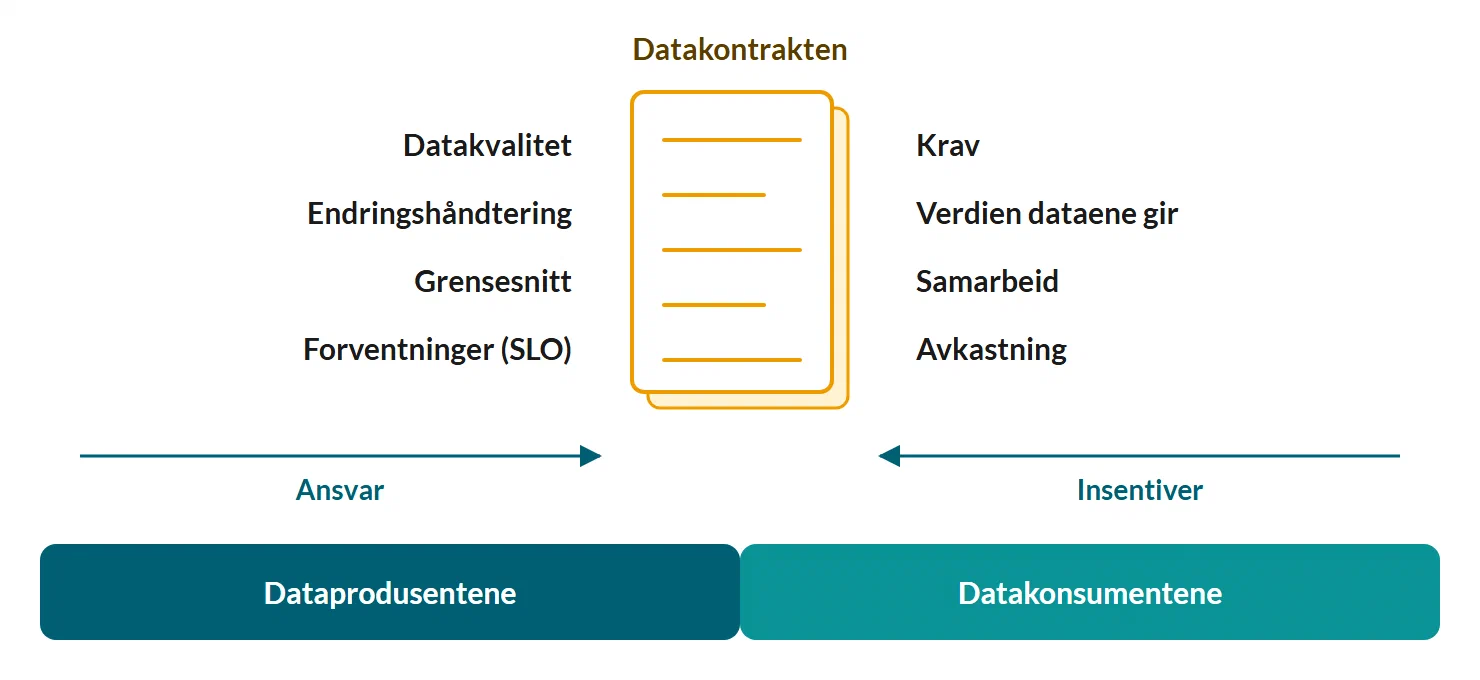
Formelt eies kontrakten av produsenten. Det er teamet som forvalter dataproduktet, som publiserer grensesnittet. Men god praksis tilsier at kontrakten utarbeides i samarbeid med konsumentene, gjerne i felles møter eller pull requests. Kontrakten skal være presis og stabil, og endringer må skje gjennom versjonering, slik at gamle konsumenter fortsatt fungerer.
Eierskapet følger kostnaden. Bare den som kan endre dataene, kan love noe om dem, og derfor må produsenten skrive og vedlikeholde kontrakten. Konsumentene slipper til gjengjeld å gjette strukturen og rykke ut hver gang den endres. I artikkelen om dataeierskap skriver vi om hvem som bør eie selve dataene, og hva det koster når ingen gjør det.
Hva vi i Glitni ser
Vi i Glitni bruker datakontrakter i prosjektene våre, og det er ikke det tekniske det står på. Skjemaet, testene og sjekken i CI/CD-pipelinen får vi på plass med verktøyene over. Det vanskelige er eierskapet og oppfølgingen: at noen eier kontrakten over tid, og at noen følger opp når den brytes.
Det er der kostnaden fra åpningen ligger. Å skrive kontrakten er en engangsjobb, mens å eie den er en del av driften, med brudd som skal håndteres og nye behov fra konsumentene som skal inn i neste versjon. Den maskinelle delen trengs fortsatt, for uten tester vet ingen at kontrakten er brutt. Men testene alene gjør ingen til eier.
Hva endrer seg når konsumenten er en AI-agent?
En AI-agent tar kontrakten bokstavelig. Den spør ikke om det den ikke vet, men fyller hullene med egne antakelser. Fra versjon 3.2.0 har ODCS fått en egen blokk, context, der produsenten kan skrive hvordan dataene skal brukes, hvilke spørsmål som har verifiserte svar, og hva en agent aldri må gjøre med dem.
context:
  instructions: >
    Bruk tabellen til å vurdere kredittrisiko i porteføljen.
    Kredittrisiko er bankens egen beregning, ikke en karakter fra et kredittbyrå.
  verifiedStatements:
    - question: "Hvor stor del av lånebeløpet har høy kredittrisiko?"
  constraints:
    - constraint: "Vis aldri enkeltkunder i et svar. Grupper på minst segment."
Freeman har prøvd dette i et workshop-repo til boka. Noen av oss i Glitni var på kurs med ham på Helsinki Data Week i oktober 2026, og han fortalte om en test han hadde gjort. En AI-assistent skriver SQL mot en database med gjenstander fra Metropolitan Museum of Art. Kilden har fire etiketter for møbler, og en femte som ligner, gjelder et beslag på et sverd. Uten hjelp svarte assistenten riktig på 1 av 10 spørsmål om slike kategorier. Da kontrakten fikk en profil som sier hvilke etiketter som hører til hver kategori, og prompten ble bygget fra profilen, svarte den riktig på 9 av 10. De enkle spørsmålene gikk samtidig ned fra 9 til 7 riktige, og Freeman kaller resultatet én kjøring og en demonstrasjon, ikke et bevis.
Det viktigste er at betydningen nå kan testes på samme måte som skjemaet. Fjerner noen en av møbeletikettene fra prompten, feiler sjekken i pull requesten og sier hvilken etikett som mangler, uten at modellen må kjøres. En ferdig ontologi fra fagfeltet er ikke nok alene. Første gang Freeman la inn Linked Art, en ontologi laget for museer generelt, ble svarene dårligere, fordi den manglet materialet treverk, som museet bruker. Konteksten må lages for de dataene den skal forklare.
Den samme tanken går igjen i artikkelen om metadata og ontologi, der et semantisk lag for AI blir en kontrakt mellom teamet og en mottaker som tar alt bokstavelig. Når agenter skriver deler av koden i en dataflyt, mener vi i Glitni at testene, datakontraktene, katalogen og dbt-prosjektet er kjernen agenten styres av og måles mot. Jo bedre den kjernen er, desto mindre betyr det hvilken modell som kjører.
Hvordan kommer dere i gang?
Velg et dataprodukt der en feil i dataene har kostet noe før, og teamet som eier det. Skriv ned det dere i praksis lover konsumentene i dag, legg kontrakten i kode og la den kjøres i CI/CD-pipelinen. Utvid med flere krav og flere team når den første kontrakten har vist at den fanger feil.
Implementering av datakontrakter krever organisatorisk forankring og støtte fra toppledelsen. Husk at det krever tid og prioritering å få på plass kontrakter, men det er mindre enn tiden dere bruker på å rydde opp i feilsituasjoner.
Hvordan dere selger det inn, avhenger av hvem dere snakker med. Andrew Jones forteller at han møter en CDO eller den som leder data governance med at dataeieren klassifiserer dataene i kontrakten, så plattformen kan håndheve reglene for oppbevaring, tilgang og kvalitet automatisk. En dataeier møter han med at kontrakten lar dem dele dataene uten å bli eksperter på datahåndtering. Funksjonene er de samme, men innsalget er ulikt.
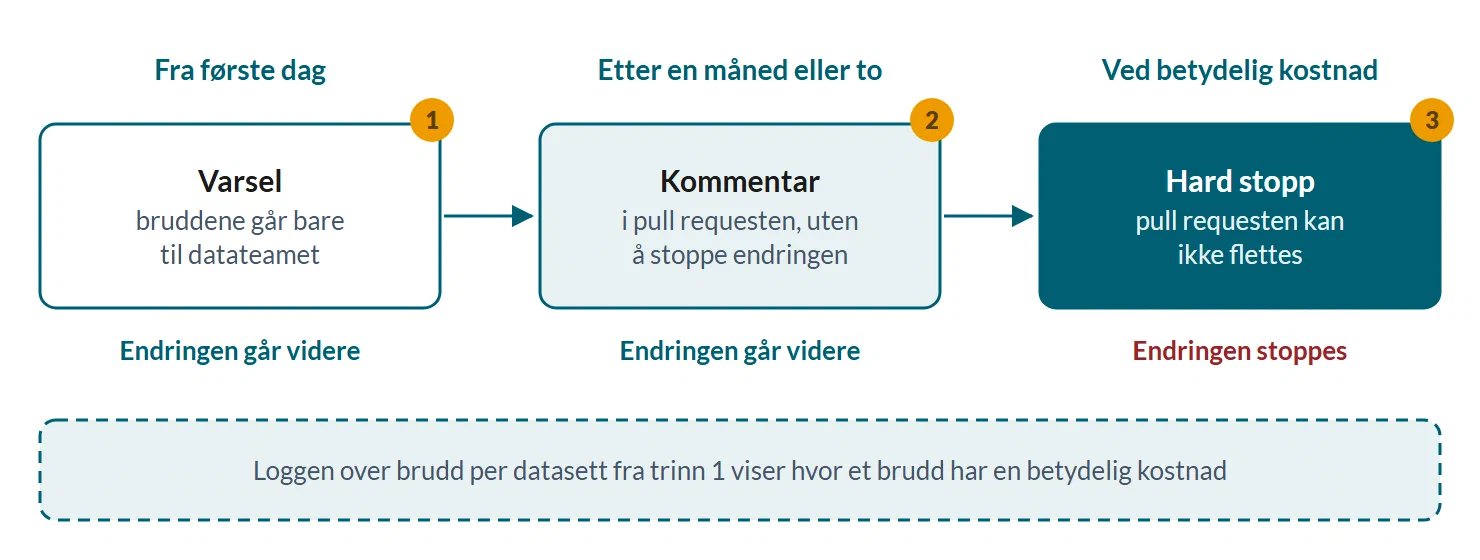
Freeman mener det er en tapt kamp å få utviklerne som lager dataene til å bry seg om dem. De bryr seg om at systemet er stabilt og at de slipper å bli vekket om natta. Kontrakten må passe inn i testene og CI/CD-pipelinen de alt har. Freeman anbefaler å ikke stoppe pipelinen med en gang. Først går kontraktsbruddene bare til datateamet, og etter en måned eller to har dere en logg over konkrete brudd per datasett å legge fram. Neste trinn er en kommentar i pull requesten som ikke stopper endringen, og harde stopp brukes bare der et kontraktsbrudd har en betydelig kostnad. Da får kontrakten vist sin verdi, også før den stopper noe.
Her er noen tips fra praksis:
- Bestem hvem som eier kontrakten og hvem som følger opp når den brytes, før dere velger verktøy
- Start med ett team og ett dataprodukt
- La bruddene først gå som varsel til datateamet, og la kontrakten stoppe endringer bare når loggen viser hva bruddene koster
- Vis frem suksesshistorier internt
- Få støtte fra CDO eller dataansvarlig fra starten
- Bruk verktøy og formater dere har fra før (for eksempel dbt, Terraform og Databricks), og legg til Data Contract CLI for testene
Start lite. Formaliser det du allerede gjør. Bygg så gradvis opp tekniske valideringer og kultur for deling og eierskap.
Vil dere ha hjelp til å skrive den første kontrakten? Send oss en melding.
Vanlige spørsmål om datakontrakter
Hva er en datakontrakt? En datakontrakt er en avtale mellom teamet som lager et datasett og teamene som bruker det, skrevet som kode slik at den kan testes automatisk. Den beskriver skjemaet, kvalitetskravene, hvor ofte dataene oppdateres og hvem som eier dem. Kontrakten fungerer som et API for data. Produsenten kan endre det som ligger bak, så lenge det kontrakten lover, fortsatt holder.
Er en dbt-kontrakt det samme som en datakontrakt? Nei. En kontrakt i dbt sjekker at modellen gir kolonnene med de navnene og datatypene dere har definert, hver gang modellen bygges. Den sier ingenting om kvalitetskrav over tid, hvor ofte dataene oppdateres eller hvem som eier dem. dbt-kontrakten kan være den delen av datakontrakten som håndhever skjemaet, men den er ikke hele kontrakten.
Hvem eier datakontrakten? Produsenten, altså teamet som forvalter dataproduktet og publiserer grensesnittet. Produsenten tar kostnaden ved å beskrive dataene og holde kontrakten ved like, men kontrakten bør skrives sammen med de viktigste konsumentene. Endringer skjer gjennom versjonering, slik at konsumenter som bruker en eldre versjon, fortsatt fungerer.
Hva er det vanskeligste med å innføre datakontrakter? Eierskapet og oppfølgingen. Skjemaet og testene lar seg sette opp med ODCS, Data Contract CLI eller dbt. I prosjektene våre står det på om noen eier kontrakten over tid, følger opp når den brytes, og tar nye behov fra konsumentene inn i neste versjon.
Hvilken standard bør vi bruke for datakontrakter? Open Data Contract Standard (ODCS) er den åpne standarden, forvaltet av Bitol i Linux Foundation AI & Data. Kontrakten skrives i YAML, og versjon 3.2.0 fra september 2026 har også en egen blokk med kontekst til AI-agenter. Data Contract CLI kan teste en ODCS-kontrakt mot dataene i blant annet Snowflake, Databricks, BigQuery og Postgres.
Når trenger vi en datakontrakt? Når flere team er avhengige av de samme dataene, når en feil koster mye, og når dataene endres ofte. Jo mer av dette som gjelder, desto større grunn er det til å skrive en kontrakt. I mange tilfeller holder det lenge å starte med feltene folk misforstår, nøklene og hvordan endringer varsles.
Hør episoden om datakontrakter
I episode 15 av podkasten Datautforskerne snakker Safurudin Mahic og Magne Bakkeli om datakontrakter. Episoden finnes på Spotify, Apple og Acast. Lik og abonnér!
Kilder
- Antonia Badarau, Irina Mugford og Massimo Frangiamore: A “meshy” approach to Data: Enabling 100+ teams to build Data Models, Monzo, 22. april 2026.
- Andrew Jones: Schema-on-read vs schema on write: It’s about the costs, nyhetsbrev, 18. september 2026.
- Andrew Jones: How to frame data contracts, nyhetsbrev, 11. september 2026.
- Andrew Jones: Data Contracts: The API for data, apidays Paris, desember 2023. Figuren uten og med datakontrakt er tegnet etter to figurer herfra.
- Andrew Jones: Implementing domain ownership with data contracts, 16. mai 2025, og Defining data products with data contracts, 23. mai 2025, nyhetsbrev.
- Andrew Jones: Driving Data Quality with Data Contracts, Packt, 2023.
- Chad Sanderson, Mark Freeman og B. E. Schmidt: Data Contracts: Developing Production-Grade Pipelines at Scale, O’Reilly, november 2025.
- Mark Freeman II: masterclass om datakontrakter og semantiske kontrakter, Helsinki Data Week, 26. oktober 2026, og workshop-repoet semantic-contracts-workshop, lest 26. oktober 2026.
- Bitol: Open Data Contract Standard, utgivelsesnotatet for versjon 3.2.0, 8. september 2026, og Bitol graduates, 28. juli 2026.
- Data Contract CLI, med dokumentasjonen.
- dbt Labs: Model contracts og Data tests, dokumentasjon, lest 16. oktober 2026.
- Great Expectations og Soda Core, GitHub, lest 16. oktober 2026.
- NOU 2024: 14 Med lov skal data deles, Digitaliserings- og forvaltningsdepartementet, 2024, og dataforvaltningsloven, lov 19. juni 2026 nr. 36.
- Digitaliseringsdirektoratet: DCAT-AP-NO, DQV-AP-NO og vokabularet for kvalitetsdimensjoner.
- datacontract.com, som figuren om dataprodukt med datakontrakt er tegnet etter, hentet 13. juli 2025.