
Innhold
En komplett guide til DataOps

Kategori: DataOps | Emneknagg: #dataops
DataOps er praksisene som gjør dataleveranser raske og pålitelige: automatisering, CI/CD, testing og observability. Denne guiden forklarer prinsippene, viser hva de betyr i praksis, og gir deg 10 steg for å komme i gang.
Kort fortalt: DataOps er smidige og automatiserte praksiser for dataproduksjon. Prinsippene fra DevOps brukes på dataplattformer, slik at leveransene blir raske, testede og til å stole på.
Mange organisasjoner har datateam som leverer saktere enn noen er fornøyd med, og dataleveranser som ryker uten at noen oppdager det før en leder peker på et rart tall i et møte. DataOps angriper begge deler.
1. Hvorfor trenger vi DataOps?
Datateam trenger DataOps av to grunner: leveransene går for sakte, og feilene oppdages for sent. Begge har samme rot, nemlig manuelle prosesser og delt ansvar mellom utvikling og drift. DataOps angriper roten med automatisering, kontinuerlig leveranse og felles eierskap for hele livssyklusen til dataproduktene.
Organiseringen av datateam skaper frustrasjon
Frustrerte brukere og ledere som ønsker seg raskere dataleveranser enn det de får fra sitt tradisjonelle datavarehus, er en vanlig situasjon. I stedet for raske leveranser havner nye behov langt bak i backlogen, bak saker som brenner mer. Og det som brenner er typisk daglig drift og nødvendige oppgraderinger, ikke verdiskapende utvikling.
Hvorfor blir det slik? Datavarehus-teamet blir fanget av egen suksess: det tar på seg dataflyter, datasett og rapporter til stadig flere brukermiljøer, alt må vedlikeholdes, og til slutt er kapasiteten til å utvikle nytt spist opp av forvaltning. Forretningen ender som kunden som aldri blir fornøyd, og IT som leverandøren som alltid prioriterer noe annet. Det skaper friksjon.
Mer komplekse dataplattformer krever nye måter å jobbe på
Dataplattformer har utviklet seg drastisk det siste tiåret: fra tradisjonelle on-premise datavarehus med ett databasesystem og ETL-verktøy, til skybaserte plattformer med objektlagring uten kapasitetstak og motorer bygget for store analytiske arbeidsmengder. Volumet og variasjonen av data har økt, og bruken har flyttet seg fra rapportering til et bredt sett av bruksområder innen AI, maskinlæring og dataleveranser til andre applikasjoner.
Data har blitt programvare. Programvare trenger data. Da må vi låne metodene fra programvareutvikling, som har modnet raskere enn dataverdenen tradisjonelt har gjort.
Hva er DataOps?
Essensen kan oppsummeres i tre punkter:
- DataOps endrer hvordan vi samarbeider rundt data. Metodikken er inspirert av DevOps og smidige prinsipper, og skal forbedre hastigheten, effektiviteten og kvaliteten på dataleveranser.
- DataOps integrerer utvikling og drift i stedet for å dele ansvaret mellom ulike team. Det gir raskere og mer responsive leveranser, tverrfaglig samarbeid og læring av feil.
- DataOps omfavner endring gjennom kontinuerlig og automatisert testing, integrasjon og leveranse av data.
Prinsippene er formulert i DataOps-manifestet, atten prinsipper undertegnet av tusenvis av praktikere, med «continually satisfy your customer» som det første.
Gevinstene er konkrete: færre feil, fordi automatisering og kontinuerlig testing fanger problemer før brukerne gjør det; høyere fart, fordi dataprodukter leveres raskere og beslutninger kan tas tidligere; og bedre samarbeid mellom datafolk og brukere, som gir mer relevante leveranser. Kostnaden er like konkret: DataOps er en ny måte å jobbe på som krever tilvenning og investering, ikke et verktøy du kan kjøpe.
2. DevOps vs DataOps
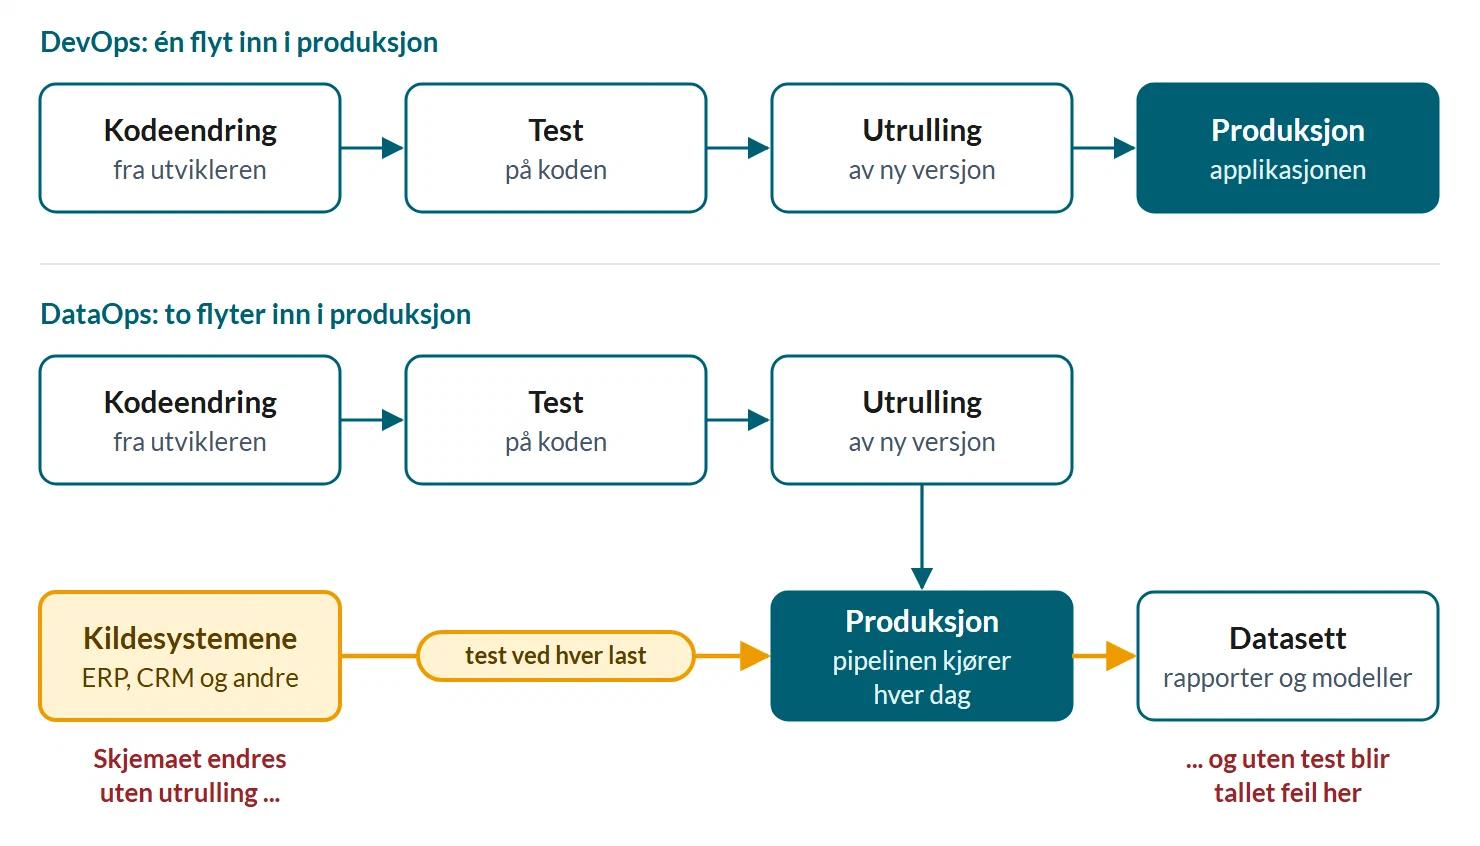
DevOps og DataOps har samme mål og mange av de samme metodene: hyppige leveranser, automatiserte tester og et team som har ansvar for både utvikling og drift. Forskjellen ligger i hva som endrer seg. I DevOps er det koden. I DataOps er det både koden og dataene, og dataene endrer seg uten at noen i teamet har rullet ut noe. Derfor trenger DataOps alt DevOps har, og i tillegg praksiser for å teste, rulle ut og overvåke selve dataene.
DevOps kombinerer utvikling og drift
DevOps er en programvareutviklingsmetodikk som forener utvikling og drift for å forbedre kvalitet, effektivitet og hastighet, samtidig som programvaren blir mer pålitelig og enklere å forvalte. Tenkningen skifter fra prosjekt til produkt og tar hele livssyklusen i betraktning. I praksis betyr DevOps smidige utviklingsmetoder og automatisering av alt som kan automatiseres: testing, versjonskontroll og CI/CD.
En avgjørende del av DevOps er å måle utviklingsprosessen og gjøre den mer effektiv, ved å fjerne hindringer og sløsing. Forskningsprogrammet DORA (DevOps Research and Assessment) måler leveransen med fem tall. Tre handler om fart: hvor lang tid en endring bruker fra commit til produksjon, hvor ofte teamet ruller ut og hvor fort det kommer seg etter en mislykket utrulling. To handler om stabilitet: hvor stor andel av utrullingene som må rettes med en gang, og hvor stor andel som er uplanlagte og skyldes en hendelse i produksjon. Ifølge DORA henger fart og stabilitet sammen: de beste teamene gjør det godt på alle fem.
Når utviklingsteamet også har ansvar for drift, blir det i utviklernes egen interesse at programvaren fungerer godt og krever lite vedlikehold. Og fra smidig arver DevOps det viktigste: klare kommunikasjonskanaler mellom interessentene og en kontinuerlig tilbakemeldingssløyfe fra sluttbrukere til utviklere.
DataOps tar det samme ansvaret for dataprodukter
DataOps kom fem år etter DevOps: den første DevOpsDays-konferansen ble holdt i Gent i 2009, og Lenny Liebmann, skribent i InformationWeek, brukte begrepet DataOps første gang i et blogginnlegg hos IBM i juni 2014. DataKitchen, som forvalter DataOps-manifestet, påpeker at et DataOps-team må ha kontroll på dataene som går gjennom produksjon, i tillegg til koden, og at dataene endrer seg uavhengig av koden.
For å forstå hvordan DataOps skiller seg fra DevOps, må vi forstå hvordan datautvikling skiller seg fra programvareutvikling. Forenklet:
Forretningsapplikasjoner automatiserer og forbedrer forretningsprosesser. Datautvikling utleder innsikt fra dataene disse prosessene og applikasjonene skaper.
Den viktigste forskjellen er kompleksiteten som følger med dataene selv. Data endres kontinuerlig og kommer fra mange kilder, noe som gjør datapipelines krevende å utvikle og vedlikeholde. I tillegg ligger datautvikling nedstrøms: den er prisgitt endringer i forretningsapplikasjonene den henter data fra, uten å eie dem. Når kildesystemet endrer et skjema, er feilen ikke din, men det er ditt dashbord som viser feil tall.
Seks forskjeller i praksis
Et DataOps-team bruker de samme verktøyene for versjonskontroll og CI/CD som et DevOps-team, men på seks områder må det jobbe annerledes:
| DevOps | DataOps | |
|---|---|---|
| Når testene kjører | Før utrulling, på koden | Før utrulling på koden, og ved hver last på dataene som kom inn |
| Testdata | Kan lages for testen | Må ligne produksjon, ellers sier testen lite om hva som skjer der |
| Utrulling | Ny kode rulles ut, og en feil rulles tilbake | Nye data trenger også en kontrollert vei til brukerne |
| Overvåking | Om tjenesten svarer, hvor fort og med hvilke feil | I tillegg om dataene er ferske, komplette og har forventet skjema |
| Hvordan feil viser seg | Oftest som en feilmelding eller noe brukerne ikke får gjort | Ofte som et tall som ser riktig ut, men er feil |
| Måling | De fem DORA-tallene | DORA-tallene for koden, men ingen felles standard for dataene |
En transformasjon kan være riktig skrevet og likevel gi feil svar på dataene den møter i produksjon. Derfor må testene kjøre mot data som ligner produksjon, og moderne dataplattformer gjør det billig. Snowflake kan klone en tabell slik at klonen i starten deler lagringen med originalen, og dbt kan bygge bare de endrede modellene og bruke produksjonsversjonen av resten.
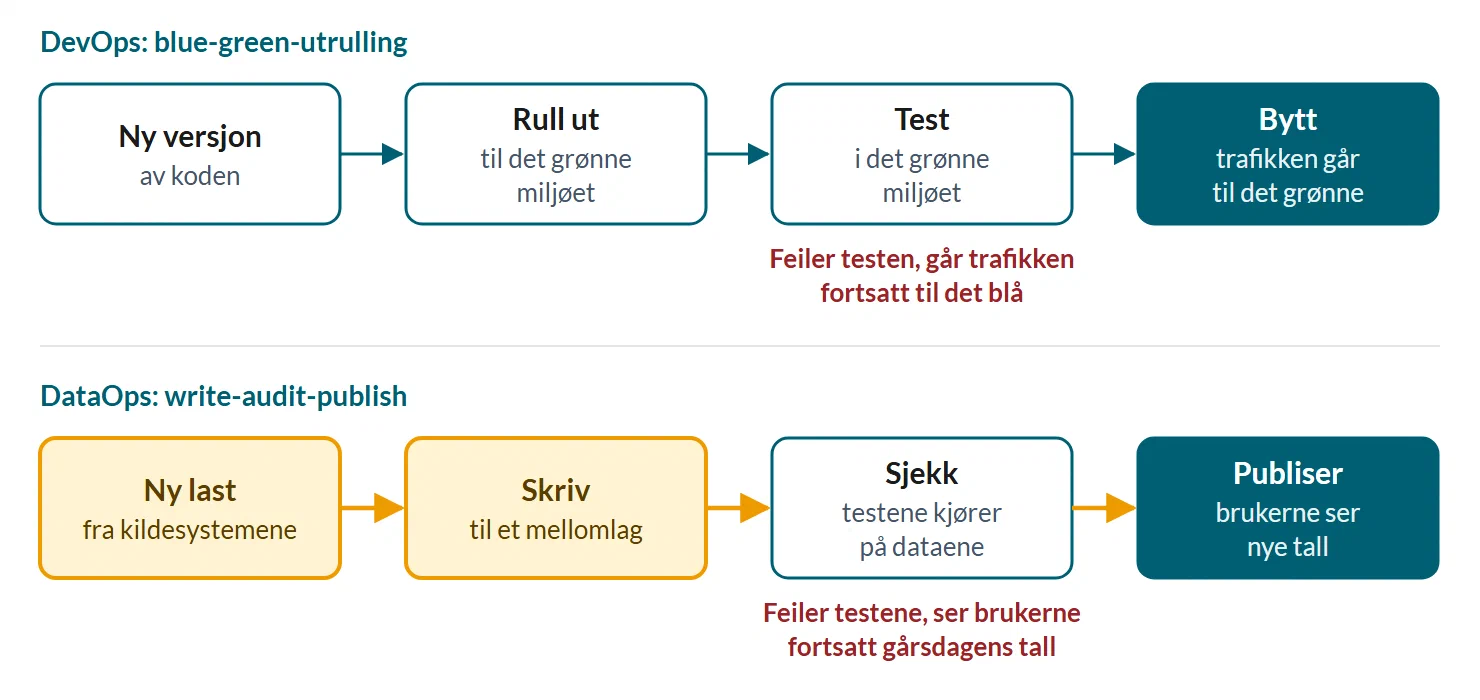
I DevOps er det koden som rulles ut, men i DataOps trenger også hver ny last med data en kontrollert vei til brukerne. Mønsteret kalles write-audit-publish: dataene skrives først til et mellomlag, sjekkes og publiseres når testene består. Write-audit-publish er dataenes utgave av blue-green-utrulling i DevOps, der den nye versjonen testes i et eget miljø før trafikken flyttes over. Apache Iceberg støtter mønsteret med egne grener på tabellnivå.
Hvor et datateam bør starte
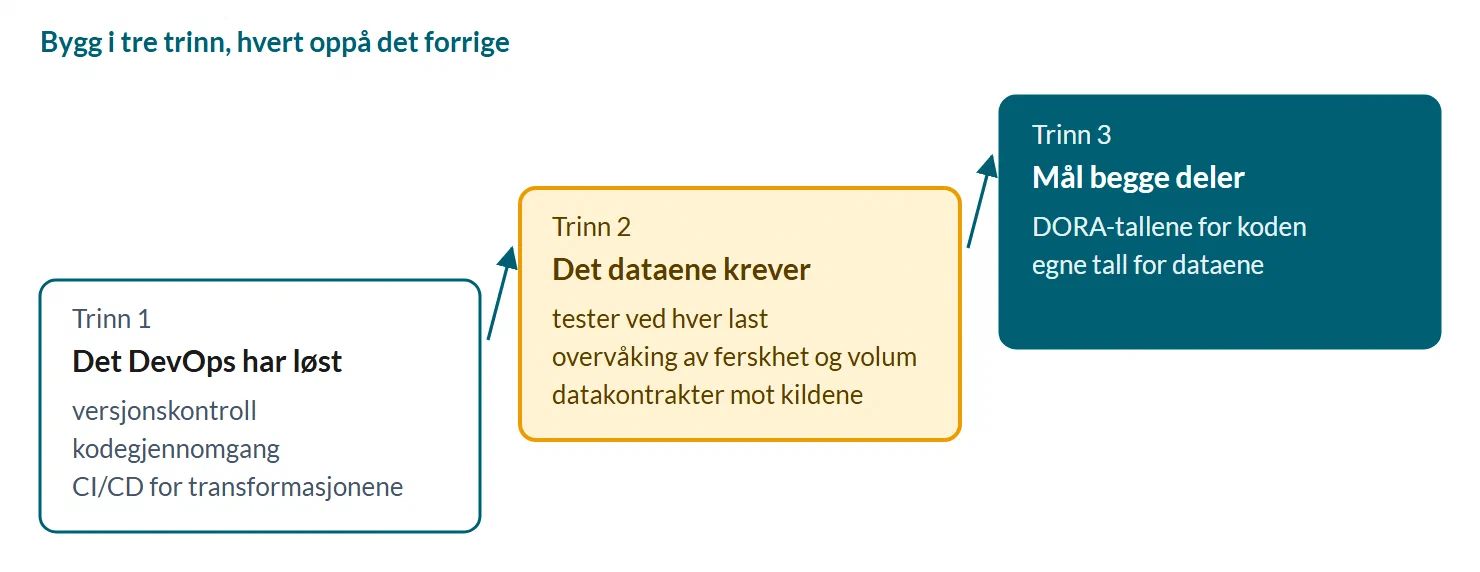
Rådet vårt er å starte med det DevOps har løst: versjonskontroll, kodegjennomgang og CI/CD for all transformasjonslogikk. Sjekk at grunnmuren holder før dere bygger videre. Mirco Hering, som vurderer hvor langt virksomheter har kommet med DevOps, beskriver en samtale han har hatt mange ganger: teamet svarer ja på at det driver kontinuerlig integrasjon, men CI-serveren bygger koden én gang i uka og kjører ingen automatiserte tester. Spør dere selv hvor ofte testene kjører, og om en feilet test stopper utrullingen.
Deretter legger dere til det dataene krever: tester som kjører ved hver last, overvåking av ferskhet og volum, og datakontrakter mot kildene som endrer seg uten å si fra. Formålet med dataene avgjør hvor strenge testene må være, og det har vi skrevet om i artikkelen om datakvalitet.
Mål begge deler: DORA-tallene viser om dere ruller ut ofte og trygt, men de sier ingenting om kvaliteten på dataene dere leverte i morges. For dataene trenger dere egne tall, for eksempel hvor ofte en tabell er forsinket og hvor mange datafeil brukerne fant før teamet gjorde det. Kapittel 5 handler om feilene som ikke utløser alarm.
3. Smidig utvikling er fundamentet for DataOps
Det meste i DevOps og DataOps er en naturlig evolusjon fra smidig utvikling: utvikle inkrementelt i små iterasjoner, levere ofte og hente tilbakemelding kontinuerlig. De fire verdiene i det smidige manifestet gjenspeiles direkte i DataOps:
- Individer og interaksjoner fremfor prosesser og verktøy: verktøy og prosesser bidrar mye i DataOps, men selv de beste hjelper ikke hvis produktet ikke leverer det brukerne trenger. Tydelige roller og tverrfaglige team som kan levere ende til ende er grunnmuren.
- Funksjonelle løsninger fremfor dokumentasjon: start med et minimums-dataprodukt og utvid etter forretningsprioritet. Ops-ansvaret i teamet gjør at utvikleren som bygde løsningen også feilsøker den, og da blir dokumentasjonen naturlig god nok, fordi ingen vil drive konstant brannslukking på egen kode.
- Samarbeid fremfor kontrakter: dataeiere, datautviklere, databrukere og infrastruktur jobber mot et felles resultat, som et team rundt en tjeneste.
- Respons på endring fremfor å følge en plan: nye datakilder, endrede forretningskrav og nye regulatoriske krav er normalen i datautvikling, ikke unntaket. Automatisering og kontinuerlig leveranse er det som gjør endring billig.
Fra Lean og kvalitetsstyring henter DataOps tre prinsipper til: eliminer sløsing og hold kode og plattform så enkel som mulig; optimaliser hele prosessen fra design til leveranse, ikke enkeltdeler; og baser forbedringsbeslutninger på målinger. Det siste er et gjentakende problem i datateam: overvåking, logging og varsling er sjelden godt nok på plass til at noen vet hvor tiden og feilene oppstår.
4. DataOps i praksis: de fire hovedområdene
I praksis består DataOps av fire områder: automatisering, kontinuerlige leveranser, kvalitetsstyring og samarbeid. Automatiseringen fjerner manuelle feil, CI/CD gjør endringer trygge å slippe fortløpende, kvalitetsstyringen fanger feilene før brukerne gjør det, og samarbeidet sørger for at leveransene treffer et reelt behov.
Automatisering
Automatisering brukes på mange områder for å øke effektiviteten og redusere risikoen for feil:
- Datainnsamling og transformasjon: automatiserte jobber henter data fra kildene, fanger feil og transformerer til analyseklare formater.
- Test og validering: automatiserte tester sikrer datakvalitet, fra enkle skjemasjekker til logiske tester på tvers av datasett.
- Orkestrering: verktøy som Airflow koordinerer lasting, transformasjon og validering i riktig rekkefølge, styrt av avhengigheter i stedet for klokkeslett. En klassisk feil er å kjøre jobb B klokken 03:00 fordi jobb A «pleier å være ferdig» da; definerte avhengigheter, retry-logikk og en backfill-strategi skiller solid orkestrering fra skjør.
- Overvåking: ytelse, feil og ferskhet spores automatisk, slik at problemer oppdages og rettes raskt.
- Modellutvikling og utrulling: versjonskontroll og CI/CD-verktøy styrer endringer mellom miljøer, også for maskinlæringsmodeller.
- Dokumentasjon: metadata, endringslogger og datalinje (data lineage) genereres fra koden i stedet for å vedlikeholdes for hånd.
- Alt som kode: forutsetningen for automatisering er at mest mulig er uttrykt som kode: infrastruktur gjennom verktøy som Terraform, transformasjonslogikk gjennom verktøy som dbt, og analyse gjennom notebooks.
Kontinuerlige leveranser
CI/CD står for kontinuerlig integrasjon og kontinuerlig leveranse, og er praksisene som gjør at endringer kan settes i produksjon fortløpende og trygt:
- Kontinuerlig integrasjon (CI): utviklere fletter kodeendringer inn i hovedgrenen ofte, og hver endring testes automatisk, slik at feil oppdages tidligst mulig.
- Kontinuerlig leveranse (CD): endringer som består testene klargjøres automatisk for utrulling til test og produksjon, med kodegjennomgang der det trengs.
Kvalitetsstyring
Kvalitetsstyring skal sikre at dataene er nøyaktige, pålitelige og nyttige. I moderne datateam struktureres testingen gjerne etter testpyramiden: flest raske, billige enhetstester i bunnen, integrasjonstester i midten (i dbt-prosjekter er det testene som kjører mot databasen, som unique og not_null), og få, dyre ende-til-ende-tester på toppen. I tillegg kommer:
- Kvalitetsmålinger i produksjon: feltet kalles data observability og har vokst til en egen komponentklasse i dataplattformer.
- Datakvalitet som kode: forventningene til et datasett, som ferskhet, komplette kolonner og gyldige verdier, deklareres i versjonert kode og håndheves nær kilden, slik at brudd fanges før de sprer seg nedstrøms. Dette er også kjernen i en datakontrakt.
- Datakataloger og lineage: metadata, kvalitetsinformasjon og sporing av dataenes opprinnelse gjør kvaliteten forståelig gjennom hele livssyklusen.
- Dialog om forretningsbehov: kvalitet er til slutt et spørsmål om «god nok til hva?», og det svaret eier forretningen, ikke datateamet.
Samarbeid
I stedet for å dele utviklings- og driftsansvar mellom ulike team, integrerer DataOps funksjonene. To prinsipper går igjen hos de som lykkes:
- Dataleveranser organiseres rundt forretningsverdi: tverrfaglige team, eid og ledet av forretningen, leverer det som skal til for å hente ut effekten, inkludert opplæring og prosessendringer, ikke bare tekniske leveranser.
- Et dedikert plattformteam leverer god bruker- og utvikleropplevelse: plattformteamet behandler utviklere og brukere som kunder, slik at data raskt kan utnyttes og bygges videre på. Vi har skrevet mer om denne modellen i Dataplattform som tjeneste.
5. Feilene som ikke utløser alarm
Grunnen til at kvalitetsstyring og observability fortjener så stor plass i DataOps, er at de farligste feilene i datapipelines ikke krasjer noe som helst. De leverer gale data stille. Ben Rogojan (Seattle Data Guy) har oppsummert fem feiltyper som passerer både syntakssjekk og enhetstester:
| Feiltype | Hva som skjer | Symptomet |
|---|---|---|
| Skjemadrift | Kilden endrer feltnavn eller datatype uten at pipelinen bryter | Nedstrøms modeller kjører videre med tomme eller gale felt |
| Delvis lasting | API-grenser eller tidsavbrudd stopper lastingen halvveis | Aggregatene ser riktige ut, men mangler noen prosent |
| Utdaterte data | Kilden sluttet å oppdatere, pipelinen kjørte fint | Dashbordet viser tall fra halvannet døgn siden |
| Sent ankommende dimensjoner | Faktarader kommer før dimensjonene er oppdatert | Koblinger gir tomme verdier uten varsel |
| Hardkodede antakelser | Forretningsregler ligger fast i SQL uten utløpsdato | Pipelinen leverer gale tall fra den dagen antakelsen sluttet å stemme |
Fellesnevneren: pipelinen kjørte, testene passerte, og dataene var likevel feil.
Det er dette som skiller monitorering fra observability. Monitorering forteller at noe gikk galt; observability forteller hvorfor, og fanger det som aldri melder fra selv. I praksis består observability av fire lag: lineage (hvor kommer tallet fra), datakvalitetsmetrikker over tid (nullrater, radtellinger, ferskhet), ytelses- og kostnadsmetrikker per kjøring, og koblingen til forretningskonsekvens. Uten det siste laget vet du at en tabell er forsinket, men ikke om det betyr noe.
Mot kildene er svaret datakontrakter: tydelige, testede avtaler om skjema, ferskhet og innhold som feiler raskt og nær kilden i stedet for å overraske nedstrøms. Gevinsten kan være målbar. Monzo, den britiske digitalbanken, har over 100 team som bidrar til et datavarehus med mer enn 12 000 dbt-modeller, og banken innførte grensesnitt: dbt-modeller som et team erklærer som en kontrakt andre team kan bygge på. Da rundt 30 prosent av migreringen var gjort, meldte Monzo om rundt 40 prosent lavere kostnader og rundt 25 prosent raskere levering av data i noen av domenene. Gevinsten kommer av hele ombyggingen, med faste modellag og automatiske standarder i CI i tillegg til grensesnittene, og banken skriver selv at det er tidlig.
6. DataOps i AI-alderen
Siden denne guiden først ble skrevet, har AI-assistert utvikling gått fra eksperiment til hverdag i datateam. dbt Labs’ bransjeundersøkelse State of Analytics Engineering 2026, med svar fra 363 datafolk og ledere, tallfester skiftet: 72 prosent prioriterer AI-assistert koding i utviklingsarbeidet, og andelen som har økt tillit til data som prioritet, har steget fra 66 til 83 prosent på ett år. Samtidig nevner 71 prosent feilaktige eller hallusinerte tall som når interessentene, som en av de største bekymringene.
Det er DataOps-poenget i et nøtteskall: AI skalerer produksjonen av analyse raskere enn verifikasjonen. Når både mennesker og AI-agenter skriver transformasjoner, blir testene, kontraktene og observabiliteten fra kapittel 4 og 5 selve begrensningen på hvor fort dere trygt kan gå. Tre konsekvenser er verdt å ta med seg:
- Dokumentasjon blir maskinlesbar infrastruktur. Modell- og kolonnebeskrivelser er et godt utgangspunkt, men en agent trenger mer: strukturert metadata om eierskap, gyldige verdier og forretningsregler, i et format den kan lese direkte. Jo bedre dokumentasjonen er, jo tryggere kan AI-verktøy generere riktige modeller uten håndholding.
- Konvensjoner må håndheves maskinelt. Stilregler og kodestandarder som bare finnes i et dokument, følges ikke av en agent som aldri har lest det. Lintere og pre-commit-sjekker håndhever konvensjonene uavhengig av hvem, eller hva, som skrev koden.
- AI flytter inn i orkestreringen. Apache Airflow har fått en offisiell provider, common.ai, som kjører modellkall og agenter med verktøy som oppgaver i arbeidsflytene. Da blir DataOps-praksisene rekkverket: uten tester, kontrakter og observability har du bare automatisert produksjonen av feil.
Kuraterte, testede og dokumenterte data var god praksis før. Nå er det forutsetningen for å bruke AI på dataene. Det er samme rekkefølge som gjelder for dataprodukter: grunnmur først, deretter AI.
7. Hvordan komme i gang: 10 steg
DataOps innføres stegvis: forstå prinsippene, forankre hos interessentene, bygg et tverrfaglig team, velg et første bruksområde med forretningsverdi, og skaler etter hvert som praksisene setter seg. De ti stegene under er rekkefølgen vi anbefaler:
- Forstå prinsippene: DataOps er mer enn verktøy; det endrer hvordan team samarbeider om data. Start med å forstå hva metodikken innebærer.
- Etabler behov og mål: identifiser problemene dagens tilnærming skaper, og definer hva dere vil oppnå, som raskere leveranser, bedre datakvalitet eller økt fleksibilitet.
- Identifiser interessentene: ledere, data engineers, analytikere og forretningsbrukere må støtte endringen for at den skal lykkes.
- Bygg et tverrfaglig team: sett sammen folk med ulike ferdigheter, fra data engineering og analyse til forretning, infrastruktur og sikkerhet.
- Finn det første bruksområdet: hent inn rådata og gjør dem tilgjengelige for et første bruksområde som gir forretningsverdi. Utvid plattformens kapabiliteter etter hvert som bruksområdene krever det.
- Etabler arkitekturprinsipper: noen overordnede prinsipper for målarkitekturen, men velg bare teknologien det første bruksområdet trenger.
- Velg verktøy: dekk datainnsamling, transformasjon, testing, orkestrering, overvåking og utrulling. Definer regler for data og metadata tidlig.
- Innfør metodene: bruk smidige metoder for arbeidsflyten, og DataOps-praksisene fra kapittel 4 for å automatisere leveransen og overvåke kvaliteten.
- Start smått og skaler gradvis: begynn med en håndterbar del av datalandskapet og utvid etter hvert som teamet får erfaring med hva som fungerer.
- Mål og forbedre: bruk måltall for datakvalitet, leveransehastighet og brukertilfredshet til å drive kontinuerlig forbedring.
DataOps er en iterativ prosess. Det viktigste er å bygge en kultur for samarbeid, kontinuerlig læring og forbedring.
Å arbeide smidig krever dessuten tid, erfaring og støtte fra organisasjonen rundt. Hvis interessentene rundt produktet ikke forstår eller kan støtte smidige leveranser, blir det vanskelig å lykkes. Det lønner seg ofte å hente inn en smidig coach med erfaring fra datautvikling i noen måneder. Og ikke bryt opp et team uten god grunn: det tar alltid tid å få et nytt team til å prestere, selv når hver enkelt er erfaren.
8. Oppsummering og vanlige spørsmål
Kort og godt om DataOps
DataOps er en metodikk som forbedrer hvordan organisasjoner samarbeider om data. Den henter inspirasjon fra DevOps og smidige prinsipper, og forbedrer hastigheten, effektiviteten og kvaliteten på dataleveranser gjennom automatisering, kontinuerlig testing og leveranse, kvalitetsstyring og tett samarbeid. De farligste datafeilene utløser ingen alarm, og derfor er observability og datakontrakter like sentrale som CI/CD. Og i en hverdag der AI genererer stadig mer av koden, er det DataOps-praksisene som avgjør om farten gir verdi eller bare raskere feil.
Vanlige spørsmål om DataOps
- Hva er DataOps? DataOps, kort for data operations, er en metodikk som forbedrer hastigheten, effektiviteten og kvaliteten på dataleveranser. Den henter prinsipper fra DevOps og smidig utvikling, og fokuserer på samarbeid, automatisering og kontinuerlig forbedring.
- Hvordan forbedrer DataOps datakvaliteten? Gjennom automatisert testing i utviklingsløpet, datakvalitet deklarert som kode nær kildene, og observability i produksjon som fanger feilene som ikke utløser alarm, som skjemadrift og utdaterte data.
- Hva er hovedforskjellen mellom DataOps og DevOps? Begge kombinerer utvikling og drift med de samme metodene. Forskjellen er hva som endrer seg: i DevOps er det koden, i DataOps er det også dataene, og de endrer seg uten at teamet har rullet ut noe. Derfor trenger DataOps i tillegg tester ved hver last, testdata som ligner produksjon, en kontrollert vei for nye data til brukerne og overvåking av selve dataene.
- Hvilken rolle spiller automatisering i DataOps? Automatisering brukes i datainnsamling, transformasjon, testing, orkestrering, overvåking, utrulling og dokumentasjon. Forutsetningen er at mest mulig er uttrykt som kode.
- Hva betyr CI/CD i DataOps? Kontinuerlig integrasjon betyr at kodeendringer flettes inn og testes automatisk flere ganger daglig. Kontinuerlig leveranse betyr at endringer som består testene kan rulles trygt ut til produksjon fortløpende.
- Endrer AI behovet for DataOps? Ja, det øker. AI-assistert utvikling skalerer produksjonen av analyse raskere enn verifikasjonen, så tester, datakontrakter og maskinlesbar dokumentasjon går fra god praksis til forutsetning.
- Hvordan kommer vi i gang med DataOps? Forstå prinsippene, samle et tverrfaglig team, velg et første bruksområde med forretningsverdi og skaler gradvis. Kapittel 7 har en 10-stegsliste med rekkefølgen vi anbefaler.
Lær mer om DataOps
- DataOps-manifestet: de atten prinsippene bak metodikken, formulert og undertegnet av praktikere.
- What Is DataOps? (DataKitchen): hvorfor et DataOps-team må styre både koden og dataene, fra selskapet som forvalter manifestet.
- Veiledningen til DORAs fem tall (DORA): hvordan fart og stabilitet i leveransen måles, som kapittel 2 viser til.
- How to build an effective DataOps team (TechTarget): hvordan organisere teamet for DataOps.
- State of Analytics Engineering 2026 (dbt Labs): bransjeundersøkelsen bak tallene i kapittel 6, om AI-adopsjon og tillit til data.
Hvordan Glitni kan hjelpe med DataOps
Vi har bygget DataOps-praksis inn i dataplattformer hos store norske virksomheter, og kan bistå med:
- Strategi og planlegging: analyse av dagens dataøkosystem, identifisering av mangler og en handlingsplan med metodikk, prosess og verktøyvalg.
- Implementering: automatiserte datapipelines, CI/CD-prosesser og observability, fra oppsett til produksjon.
- Verktøyvalg og integrasjon: valg og integrasjon av verktøy for transformasjon, orkestrering, overvåking og infrastruktur som kode, tilpasset behovet deres.
- Opplæring og endringsledelse: DataOps krever ofte et kulturskifte. Vi har lang erfaring med endringsprosesser innen data, og sørger for at teamet både forstår og eier den nye måten å jobbe på.
Vurderer dere DataOps, eller har dere en dataplattform der leveransene går tregere enn dere ønsker? Send oss en melding for en prat.